Fraude eleitoral e os picos ausentes no Brasil.
Aplicamos à eleição presidencial de 2026 o teste que expôs fraudes nas eleições russas: os picos em percentuais inteiros não aparecem no Brasil.
Desde 2004, um teste estatístico simples tem exposto repetidamente a fabricação de resultados nas eleições russas. O teste não depende de informantes nem de documentos vazados. Exige apenas os boletins de urna oficiais de cada seção eleitoral, um pouco de aritmética e uma regularidade do comportamento humano: quando as pessoas inventam números, elas preferem os redondos. Neste artigo, aplicamos o mesmo teste à eleição presidencial brasileira de 2026. Primeiro explicamos como o teste funciona, depois descrevemos os dados brasileiros e os resultados e, por fim, discutimos o que o teste pode e o que não pode nos dizer.
O teste dos números inteiros
Imagine que você administra uma seção eleitoral com 318 eleitores aptos (o tamanho médio de uma seção eleitoral no Brasil) e seus superiores esperam um bom comparecimento. Você decide informar, digamos, 85%. Para chegar a esse número, precisa registrar 270 votos depositados na urna, e 270 parece um número qualquer. Ninguém que auditasse sua seção suspeitaria que o valor foi inventado. No entanto, se centenas de seções em todo o país fizerem a mesma coisa, cada uma escolhendo uma meta conveniente como 85%, 90% ou 95%, algo incomum aparece quando todos os números de comparecimento são plotados juntos: picos estreitos em percentuais de números inteiros, bem acima dos valores vizinhos. Picos em 91%, 92% e 93% se destacariam claramente do restante da distribuição.
Kobak, Shpilkin e Pshenichnikov (2016) desenvolveram um método para detectar esse padrão. Eles examinaram o caso russo e identificaram múltiplos picos na distribuição do comparecimento que são estatisticamente improváveis de ocorrer por acaso. Na Alemanha, na Polônia e na Espanha, não encontraram nada comparável. Os picos não provam quem fez o quê, mas são muito difíceis de explicar por qualquer outro motivo que não seja a manipulação de dados.
Por que fazer essa pergunta sobre o Brasil
A eleição presidencial brasileira de 2026 terminou em surpresa. Flávio Bolsonaro, filho do ex-presidente preso Jair Bolsonaro, venceu o primeiro turno em 4 de outubro com 47,03% dos votos válidos, e as pesquisas finais indicavam que ele também venceria o segundo turno. Três semanas depois, Lula venceu o segundo turno com 51,78%. Nada parecido havia acontecido desde que o Brasil retornou às eleições presidenciais diretas em 1989: o líder do primeiro turno nunca havia perdido o segundo. Os mercados acionaram o circuit breaker no primeiro pregão após a votação. Bolsonaro filho alegou fraude e voou com sua família para os Estados Unidos no meio da noite. Donald Trump, em declaração oficial, inicialmente repetiu a acusação e recusou-se a reconhecer o resultado.
A apuração foi adulterada? As intenções não podem ser observadas, mas os resultados de cada seção podem, e permitem uma verificação direta. O Brasil, assim como a Rússia, publica os boletins de todas as seções eleitorais — todas as 498.950 no segundo turno —, com o número de eleitores aptos, votos totais e votos para cada candidato (https://dadosabertos.tse.jus.br/). A seguir, replicamos a metodologia de Kobak, Shpilkin e Pshenichnikov (2016) para o caso brasileiro.
O que os histogramas mostram
As Figuras 1(a) e 1(b) são as versões brasileiras dos histogramas russos. Cada curva contabiliza quantas seções eleitorais registraram um determinado comparecimento, ou uma determinada proporção para o candidato líder, em intervalos de um décimo de ponto percentual de largura. Se funcionários estivessem direcionando os resultados para números redondos, esperaríamos ver picos nos percentuais de números inteiros.
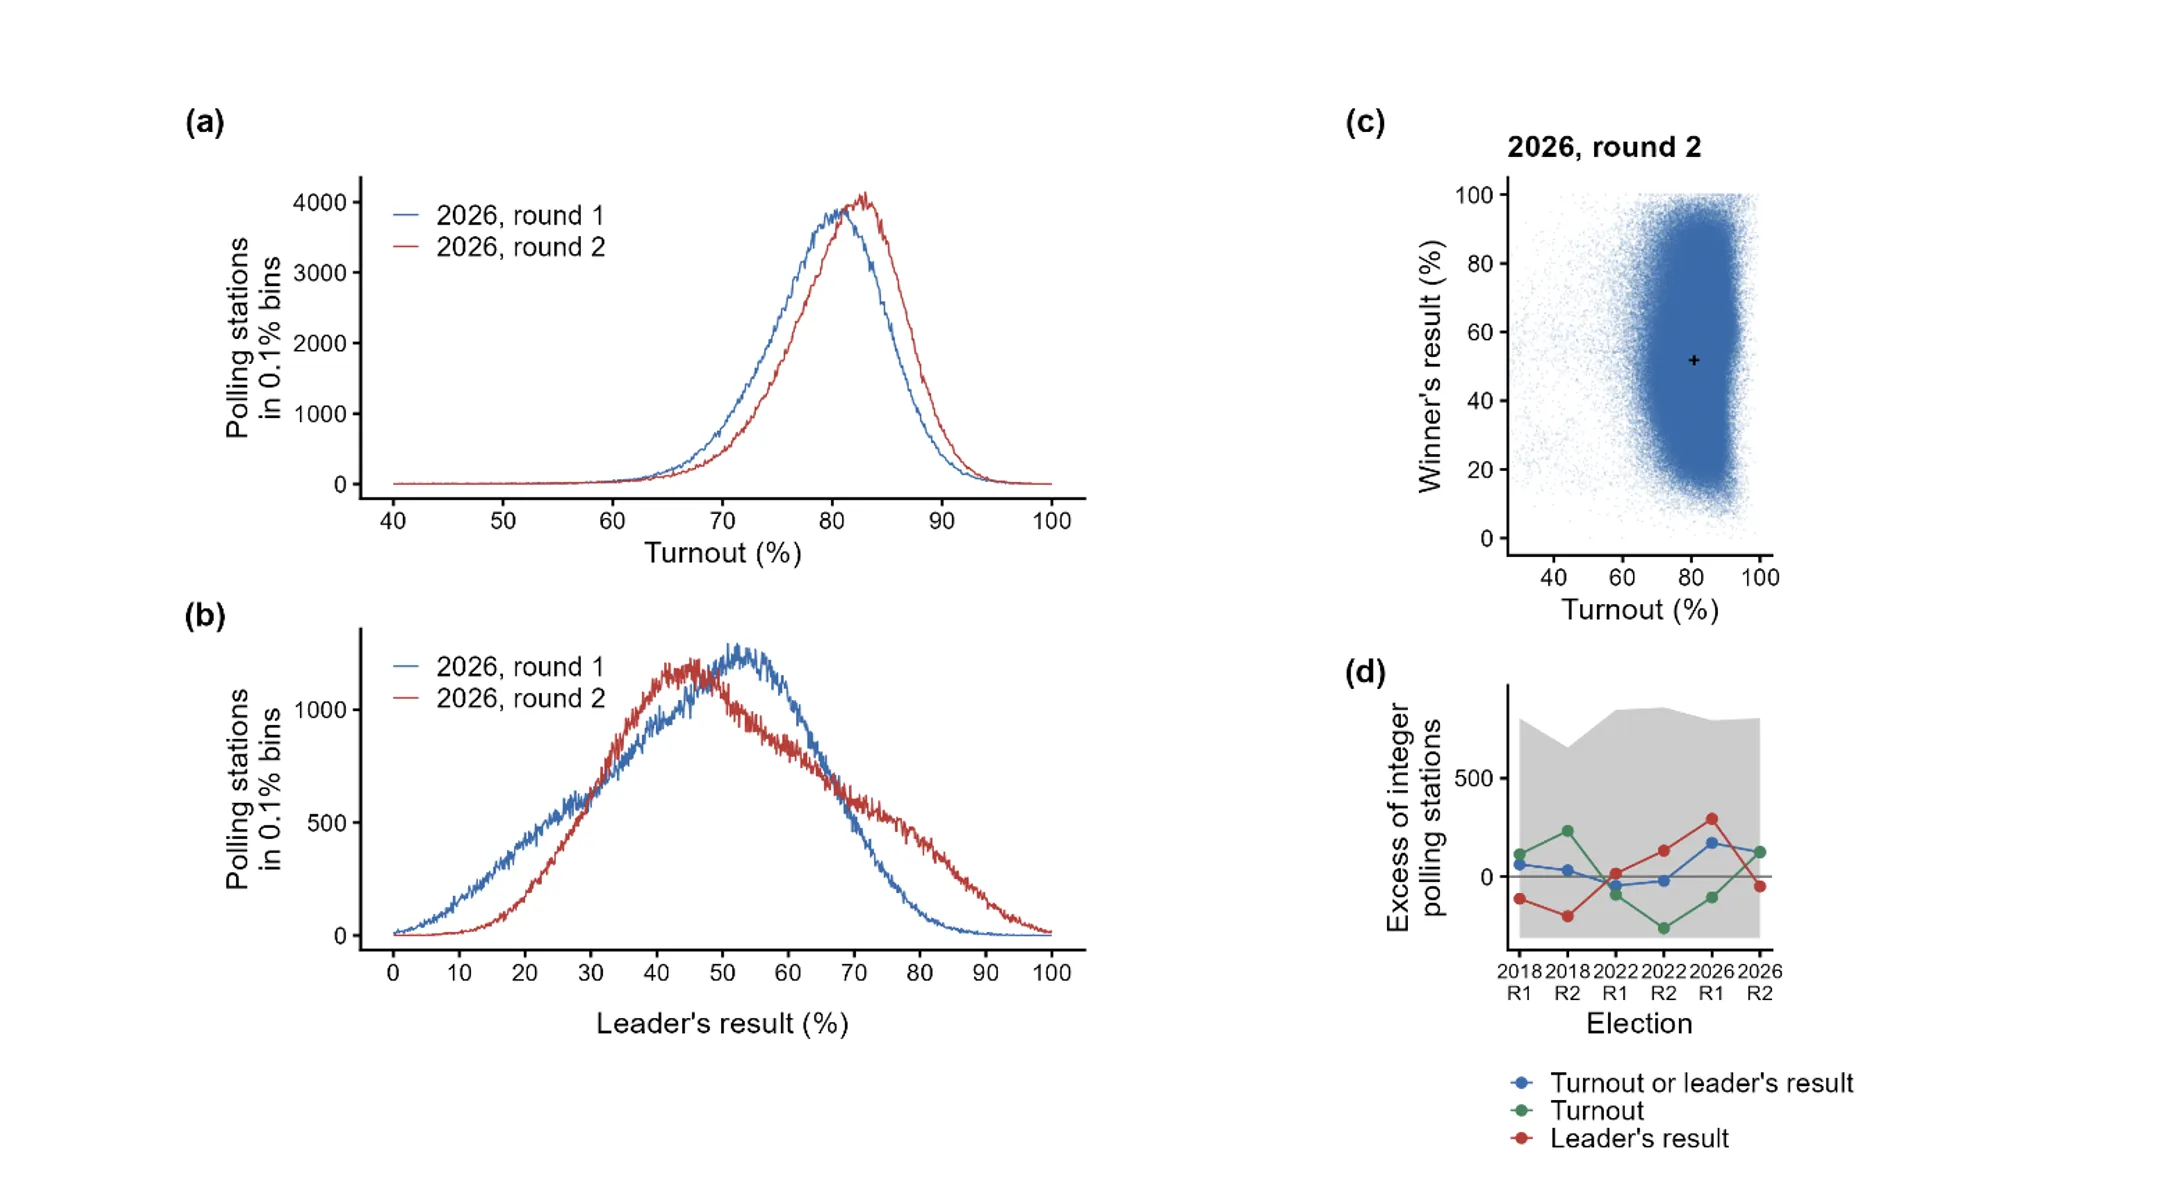
Figura 1. (a) Comparecimento e (b) proporção de votos válidos do candidato líder nas seções eleitorais brasileiras nos dois turnos de 2026, contabilizados em intervalos de um décimo de ponto de largura. Seguindo Kobak, Shpilkin e Pshenichnikov (2016), adicionou-se uma pequena variação aleatória (jitter) a cada contagem para que a divisão de um número inteiro por outro não produza picos artificiais; seções com 100% de comparecimento foram excluídas. O líder foi Flávio Bolsonaro no primeiro turno e Lula no segundo turno. (c) Cada seção no segundo turno, plotada de acordo com seu comparecimento e sua votação para Lula; a cruz marca o resultado nacional. (d) A anomalia dos números inteiros: o número de seções que registraram um comparecimento ou resultado em número inteiro acima do que o acaso produziria, em cada um dos seis turnos eleitorais desde 2018. A faixa cinza mostra o intervalo que o acaso por si só pode produzir; um ponto acima dela teria menos de uma chance em mil de ocorrer por acidente. Não encontramos tais picos. As curvas são irregulares, mas a irregularidade é do tipo esperado a partir de meio milhão de contagens independentes: ela se espalha uniformemente por toda a extensão, sem concentração em 80% em relação a 80,3%, por exemplo. O formato geral das curvas também é informativo. Cada distribuição possui uma única moda, e a Figura 1(c), que plota cada seção pelo seu comparecimento e sua votação para o vencedor, mostra uma única nuvem de pontos.
A anomalia dos números inteiros
A inspeção visual não é suficiente, portanto o teste também produz um número. Para cada seção, verificamos se o seu comparecimento, ou o resultado do candidato líder, situava-se dentro de um vigésimo de ponto percentual de um número inteiro, e contamos as seções em que pelo menos um dos dois casos ocorria. Em seguida, perguntamos quantas seções desse tipo existiriam se ninguém estivesse direcionando os resultados. Para responder a essa pergunta, simulamos cada eleição 1.000 vezes. Cada seção manteve seu tamanho real e suas propensões reais, mas seus votos foram sorteados aleatoriamente, como se seus eleitores tivessem lançado moedas viciadas. A diferença entre a contagem observada e a média simulada é o que Kobak, Shpilkin e Pshenichnikov (2016) chamam de anomalia dos números inteiros, e é essa grandeza que está plotada na Figura 1(d).
Na Rússia, a anomalia dos números inteiros tem oscilado em torno de mil seções desde 2004, alcançou cerca de duas mil em 2008 e 2018, e atingiu 3.670 em 2020 — todas as vezes muito acima da faixa cinza do que o acaso pode produzir. No Brasil, o valor é de 171 no primeiro turno de 2026, o maior dos seis valores, contra uma faixa que chega a 795. No primeiro turno de 2022, o valor é, na verdade, negativo: houve 46 seções com números inteiros a menos do que o acaso preveria. Somando todos os seis turnos, observamos 535.137 seções com números inteiros contra 534.817 esperadas. Também testamos as variações óbvias, acompanhando Lula em vez de Flávio Bolsonaro no primeiro turno de 2026 e calculando as proporções sobre o total de votos depositados na urna, como faz a lei russa, em vez de sobre os votos válidos, como determina a lei brasileira. Nenhum desses resultados sai de dentro da faixa esperada.
O que isso de fato nos diz
O teste que identificou os picos russos não encontra nenhum no Brasil. É importante deixar claro o alcance dessa afirmação. A anomalia russa provavelmente é produzida por mãos humanas: alguém preenche um formulário com um percentual em mente. Os resultados brasileiros saem das urnas eletrônicas como contagens e são transmitidos a Brasília como contagens. Nunca se pede a ninguém em uma seção eleitoral brasileira que informe um percentual. Assim, o comportamento específico que este teste foi projetado para detectar não tem oportunidade de ocorrer. Passar no teste é, portanto, compatível com uma eleição limpa, mas também com uma eleição fraudulenta na qual a manipulação nunca envolveu números redondos. Ainda assim, vale a pena saber o que o teste de fato descarta. Se a apuração de 2026 tivesse sido manipulada da maneira como as apurações russas foram, a evidência apareceria em um gráfico simples o suficiente para ser impresso em uma única página. Procuramos por essa evidência em seis turnos eleitorais e não a encontramos. Este artigo é o primeiro de uma série futura que utilizará métodos de perícia eleitoral para avaliar a integridade, a consistência e a confiabilidade dos dados eleitorais das eleições presidenciais brasileiras de 2026. A série é uma iniciativa do The Transparent Ballot Box Project (Projeto Urna Transparente), desenvolvido pela Transparência Eleitoral.
O método e o código de Dmitry Kobak e colegas estão descritos na Annals of Applied Statistics 10(1), 2016, e na Significance (2016, 2018, 2020).
Os materiais para replicação estão disponíveis em: https://osf.io/b3y78.
Publicado originalmente em inglês pelo King's College London, em 6 de novembro de 2026. Republicado com autorização dos autores.