Por que evitar mergulhar fundo nos cruzamentos das pesquisas eleitorais.
Estimativas por sexo, idade ou região têm erros maiores do que a margem de erro nacional, e às vezes maiores do que a própria margem reportada para elas.
Eu costumo dizer que devemos evitar mergulhar muito a fundo em cruzamentos (crosstabs) de pesquisas pré-eleitorais. Aqui eu explico um pouco mais sobre isso.
Primeiramente, estimativas de cruzamentos, como por sexo, idade, região etc., possuem um tamanho amostral menor, então a margem de erro delas vai ser necessariamente maior do que a reportada para as estimativas nacionais.
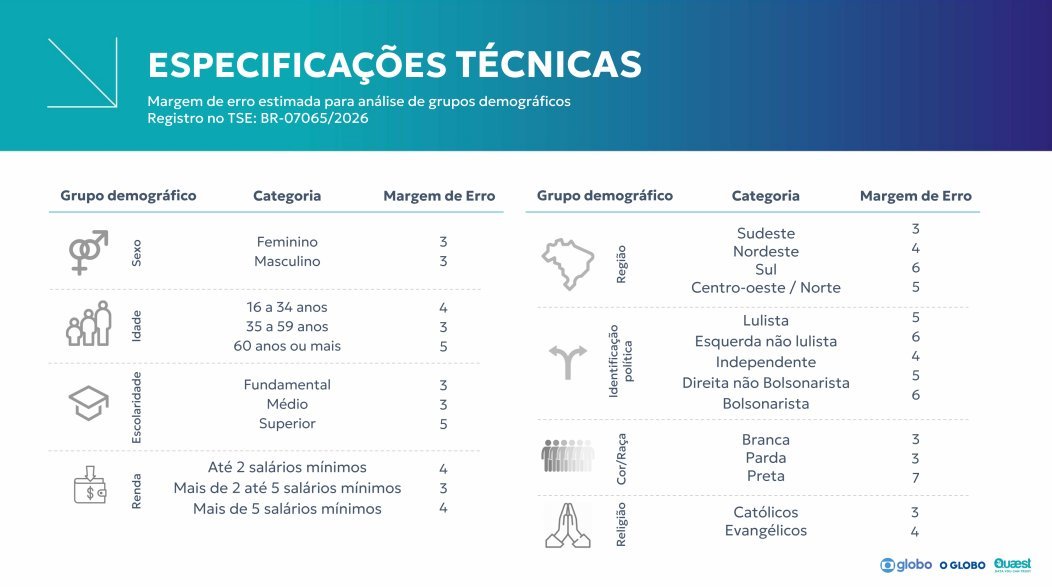
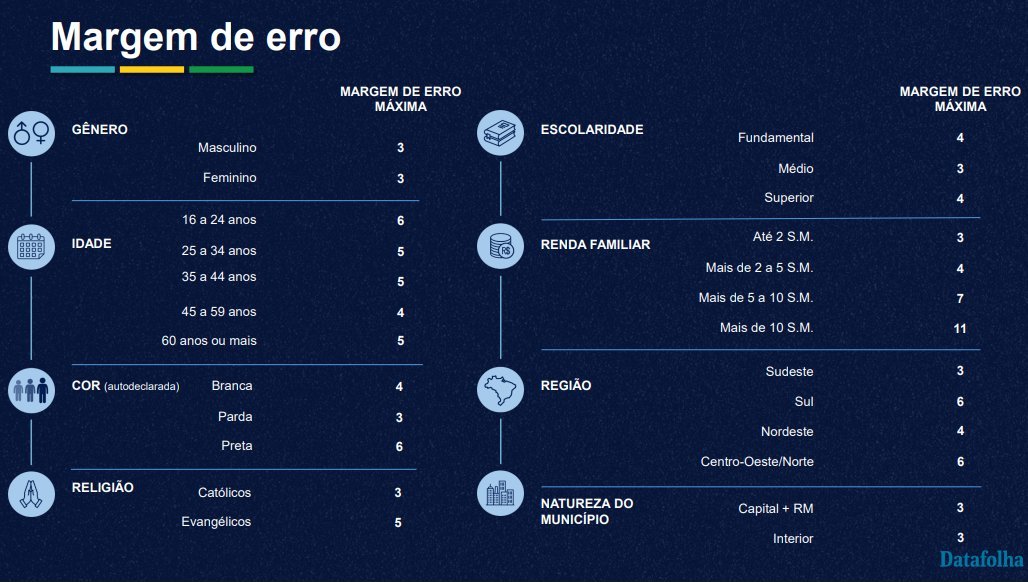
Alguns institutos, como a Quaest, Datafolha e Nexus, têm colocado nos seus relatórios as margens de erro máximas para cada subgrupo. Já a Palver coloca a margem de erro para cada estimativa separadamente (e considerando o efeito dos pesos adequadamente!), o que é ainda melhor.
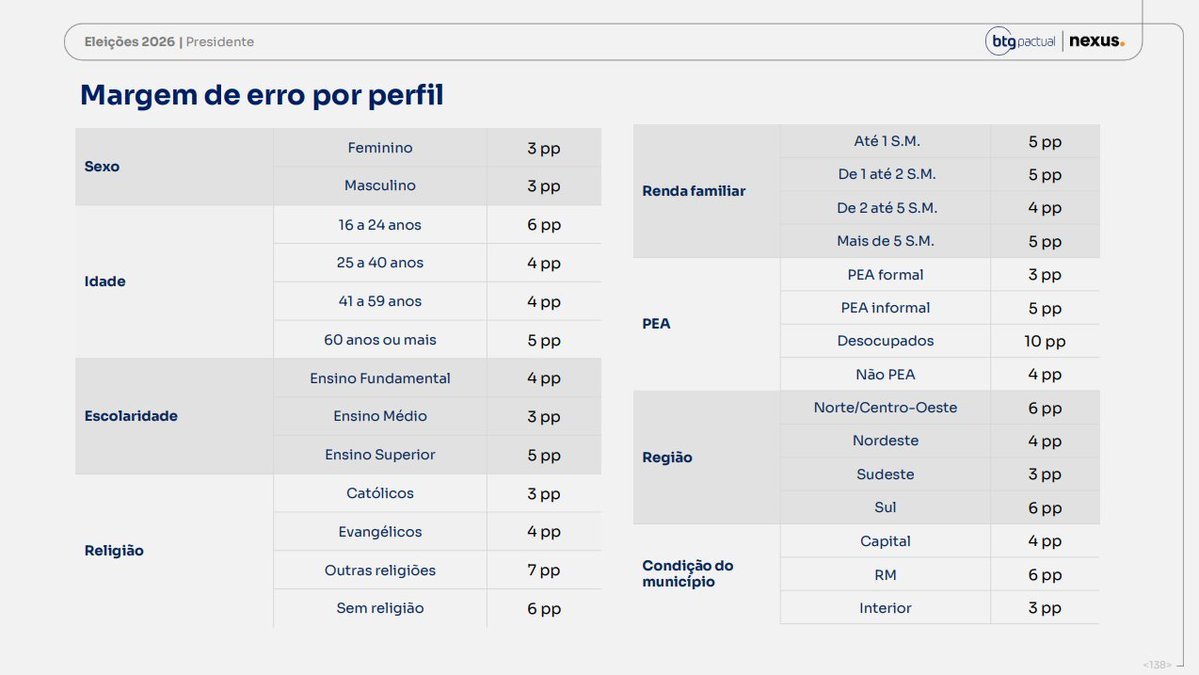
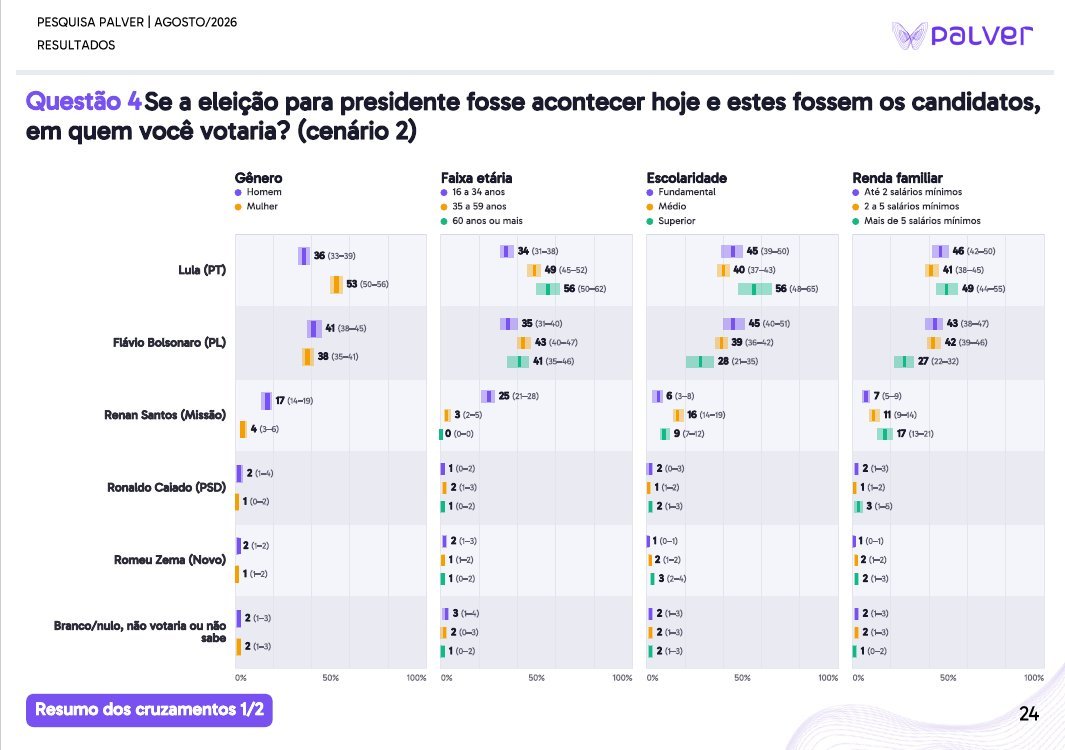
Entretanto, um outro ponto que não é tão abordado quanto a isso é que, em geral, os institutos ponderam suas pesquisas para estarem bem calibradas nacionalmente, mas não necessariamente para cada um dos subgrupos.
Por exemplo, a amostra é ponderada por sexo, idade, escolaridade (e região) nacionalmente, mas não por sexo, idade e escolaridade para cada uma das regiões separadamente. Então, essas estimativas de subgrupos estão sujeitas a um erro ainda maior do que a margem de erro reportada.
Por isso, é tão importante saber como os institutos estão calibrando suas amostras. Estão calibrando apenas pelas marginais de cada variável, ou também estão calibrando dentro de diferentes subgrupos? Por exemplo, a Palver deixa isso muito claro no relatório deles:
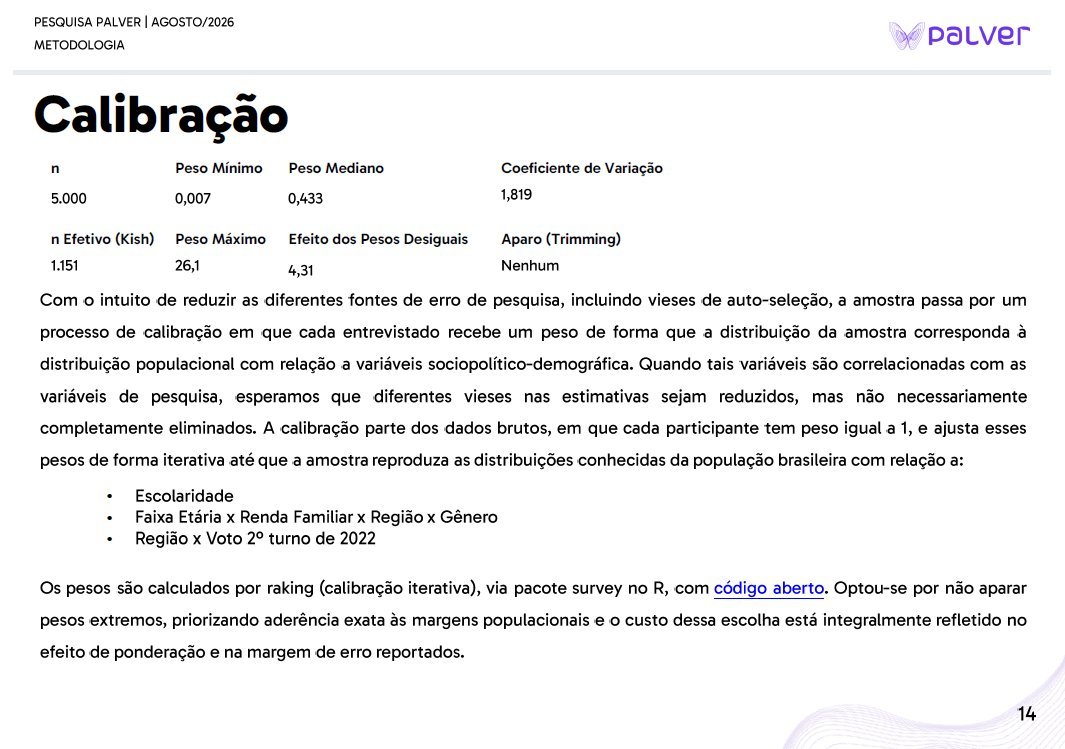
Se a amostra não é calibrada para cada um dos subgrupos, suas estimativas podem estar sujeitas a erros ainda maiores do que as margens de erro máximas reportadas para elas. E é justamente por isso que deve-se evitar analisá-las excessivamente (ou mergulhar a fundo nelas).
Esse é um dos motivos pelos quais é tão importante ter uma maior transparência metodológica: para sabermos justamente a que ponto devemos esperar esse tipo de estimativas com erros maiores do que até além da margem de erro reportada, e levar isso em consideração.
Publicado originalmente como fio no X (antigo Twitter), em 8 de setembro de 2026.